

文字识别(OCR)
文字识别返回图片中找到的文字行,每一行包含文字、置信度、外接框、四边形,默认还包含字级框。每次调用处理一张图片,与行数无关。典型用途包括截图、界面截屏、小票、代码窗口、裁剪区域,以及需要原样复制文字的场景。如需文档页面的版面(阅读顺序、表格、公式),请参阅文档解析。
图片中找到的每一行文字作为 lines 的一项返回,包含识别出的 text、confidence、与坐标轴对齐的 bbox 以及四个角点的 quad;对倾斜文字,quad 比 bbox 更贴合。低于 options.minConfidence(默认 0.5)的行会被丢弃。
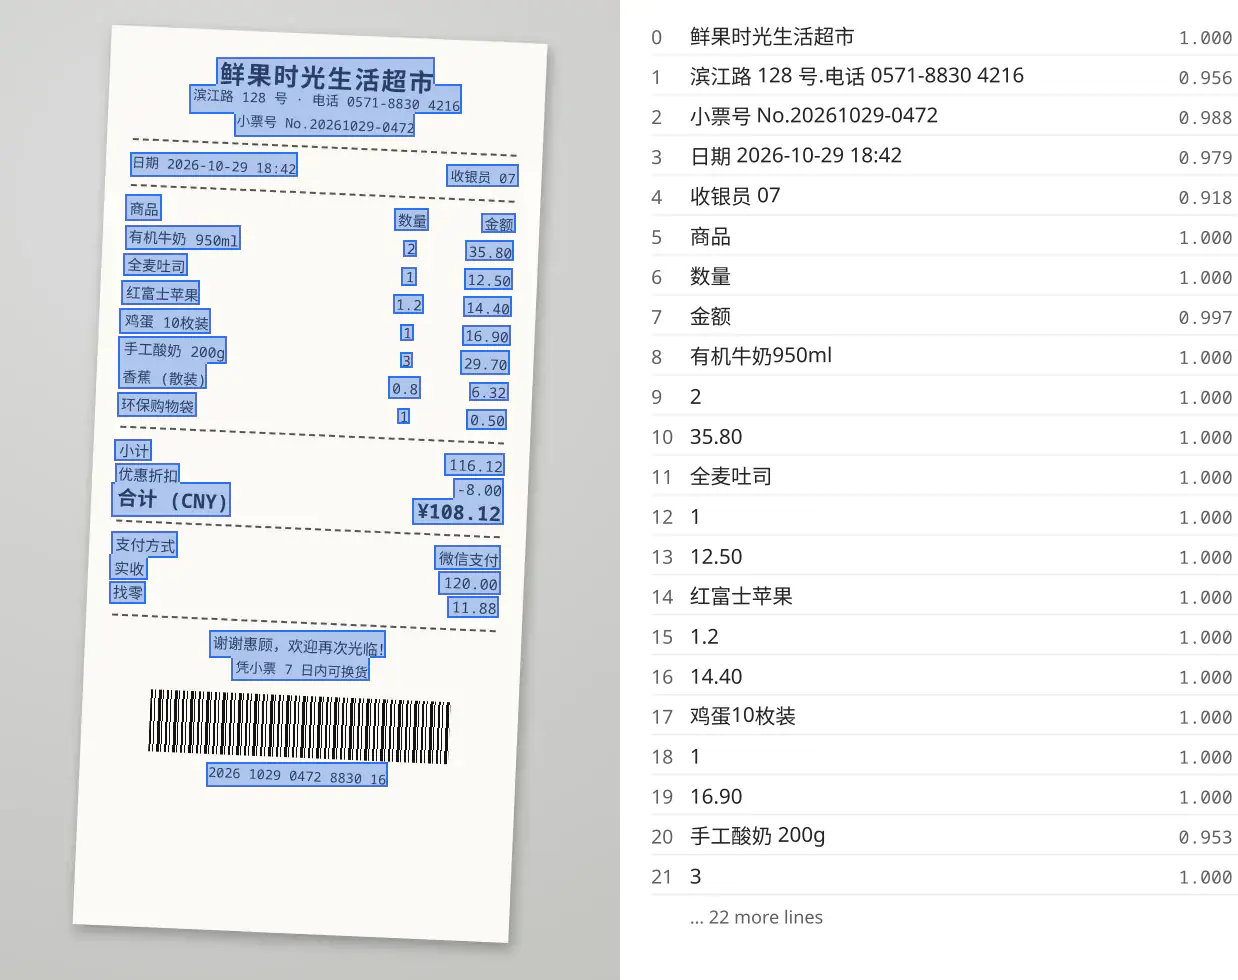
ppocr-v6:Playground 对一张拍摄的、略有旋转的小票的实录结果。每个框是 lines 的一项;右侧列表显示 text 和 confidence,共 44 行,此处为前 22 行。
options.words(默认 true)开启时,每一行带有 words:该行的各个片段,各有 text、confidence、bbox 和 quad。字级框用于定位行内的单个词元,例如高亮搜索命中,或确定点击位置。空白字符可能单独作为一个字出现。options.words 为 false 时不返回 words,响应更小。
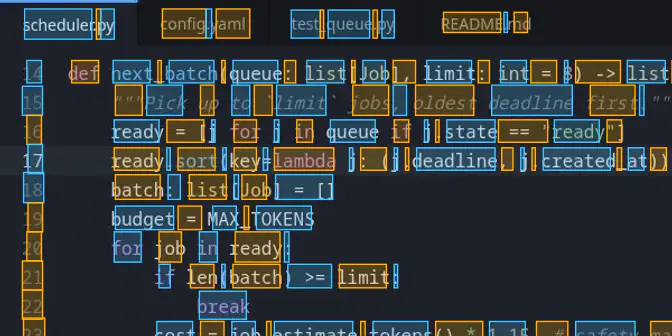
ppocr-v6:Playground 对一张编辑器截图的实录结果。每个框是 lines[].words 的一项;两种颜色交替出现,仅用于区分相邻的字。
ppocr-v6 是 POST /v1/ocr 的默认模型,也是唯一的模型。
纯文字行由 ppocr-v6 提供。paddleocr-vl 同样能读取任何页面图片,但它是按页计费的文档解析器,通过 POST /v1/documents/parse 调用;下表对比两者在读取文字方面的差异。
ppocr-v6 |
paddleocr-vl |
|
|---|---|---|
| 模型 | PP-OCRv6 small | PaddleOCR-VL 1.6(0.9B),配合 PP-DocLayoutV3 版面分析 |
| 接口 | POST /v1/ocr |
POST /v1/documents/parse |
| 输入 | 一张图片:截图、裁剪区域、照片 | 一页图片 |
| 输出 | 文字行,含置信度、框、四边形和字级框 | 按阅读顺序排列的版面区块、HTML 表格、LaTeX 公式、整页 Markdown |
| 标价(额度) | 每张图片 0.25 | 每页 2 |
| 模型池 | 公共池:所有已注册账户可用,每个 UTC 日包含 100 次调用 | 付费池:从余额中扣费 |
| 录制的处理时间 | 753 ms(一次录制的调用) | 1294 ms(一次录制的调用) |
| 适用场景 | 需要原样复制文字 | 需要版面、阅读顺序、表格或公式 |
- 截图、界面截屏、小票、代码窗口和裁剪区域,以及成本最重要时,选用
ppocr-v6。把文字行归并为段落或分栏由调用方自行处理。 - 发票、论文、报告和书页需要区块、阅读顺序、表格和公式时,选用
paddleocr-vl。详见文档解析。
将一张账户设置页的截图以默认选项发送到 POST /v1/ocr:
curl https://api.stack.foldbun.com/v1/ocr \ -H "Authorization: Bearer $FOLDBUN_API_KEY" \ -H "Content-Type: application/json" \ -d '{ "model": "ppocr-v6", "image": { "id": "img_2dedd0716bfd46ec29b286a279d18b6fc80631e5d90fedb5c63eb36f231622e6" }, "options": { "minConfidence": 0.5 } }'以下响应有删减:只显示识别出的其中一行。
{ "id": "call_01a1913d-55cd-7bee-ba86-bbbef2aa9bae", "model": "ppocr-v6", "image": { "id": "img_2dedd0716bfd46ec29b286a279d18b6fc80631e5d90fedb5c63eb36f231622e6", "width": 1100, "height": 760, "bytes": 83478, "contentType": "image/jpeg" }, "lines": [ { "text": "Sign out", "confidence": 0.9786, "bbox": [982, 32, 1053, 56], "quad": [[982, 32], [1053, 32], [1053, 56], [982, 56]], "words": [ { "text": "Sign", "confidence": 0.9786, "bbox": [990, 32, 1018, 56], "quad": [[990, 32], [1018, 32], [1018, 56], [990, 56]] }, { "text": " ", "confidence": 0.9786, "bbox": [1018, 32, 1022, 56], "quad": [[1018, 32], [1022, 32], [1022, 56], [1018, 56]] }, { "text": "out", "confidence": 0.9786, "bbox": [1026, 32, 1050, 56], "quad": [[1026, 32], [1050, 32], [1050, 56], [1026, 56]] } ] } ], "cost": 0.25, "balance": 12.5, "timing": { "queueMs": 0, "processingMs": 753 }, "billing": { "lines": [ { "unit": "image", "quantity": 1, "unitPrice": 0.25, "amount": 0.25, "waived": false } ], "total": 0.25, "charged": true, "pool": null }}lines为识别出的文字行,按自上而下、再自左而右排序。模型不做版面分析:阅读顺序和段落划分由调用方处理。每一行包含text、confidence(此处为 0.9786)、bbox和quad。bbox为[x1, y1, x2, y2],quad为该行的四个角点,单位均为摆正后的原图的像素,此处为 1100 × 760(image.width、image.height)。角点的顺序见 API 参考。words将该行拆分为各有text、confidence、bbox和quad的片段:此处为Sign、一个空格和out,因为空白字符可能单独作为一个字出现。options.words设为false时不返回words。billing.charged为true,pool为null:本次调用从余额中扣费,因此cost为 0.25。
全部字段:API 参考。
本次调用的费用。 每次调用 0.25(image)额度,与行数、词数无关,与本响应的实际扣费一致。公共池每日额度内的调用不扣费。单价见计费。
| 接口 | 在本用例中 | 参考 |
|---|---|---|
POST /v1/ocr |
从一张图片得到文字行及其置信度、框和四边形,默认还含字级框 | API 参考 |
POST /v1/documents/parse |
返回结构(区块、表格、公式),而不是纯文字行 | API 参考 |
ppocr-v6和paddleocr-vl:各模型的工作原理、限制和实测延迟。- 计费:各模型的计费单位;
ppocr-v6每次调用计一个image。 - 文档解析:整页的区块、阅读顺序、表格和公式。
- 图片:框和四边形所用的像素坐标。