

文档解析
文档解析找出页面的版面区块(文本、标题、表格、公式、图片等),识别每个区块,并按阅读顺序返回各区块,同时返回整页的 Markdown。表格以 HTML 表格表示,公式以 LaTeX 表示。典型用途是把发票、论文、报告和书页转换为结构化文本。每次请求为一页图片。多页 PDF 输入暂不可用。如需读取截图或裁剪区域中的纯文字行,请参阅文字识别(OCR)。
版面区块与阅读顺序
Section titled “版面区块与阅读顺序”页面的每个区域作为 blocks 的一项返回,包含 type、order、bbox,以及识别出的 text 和 markdown。type 为 text、title、table、formula、figure、caption、header、footer、list、other 之一。order 为阅读顺序,从 0 开始,由模型判定;下图中的页面按栏依次阅读。响应的 markdown 字段按该顺序拼接各区块。
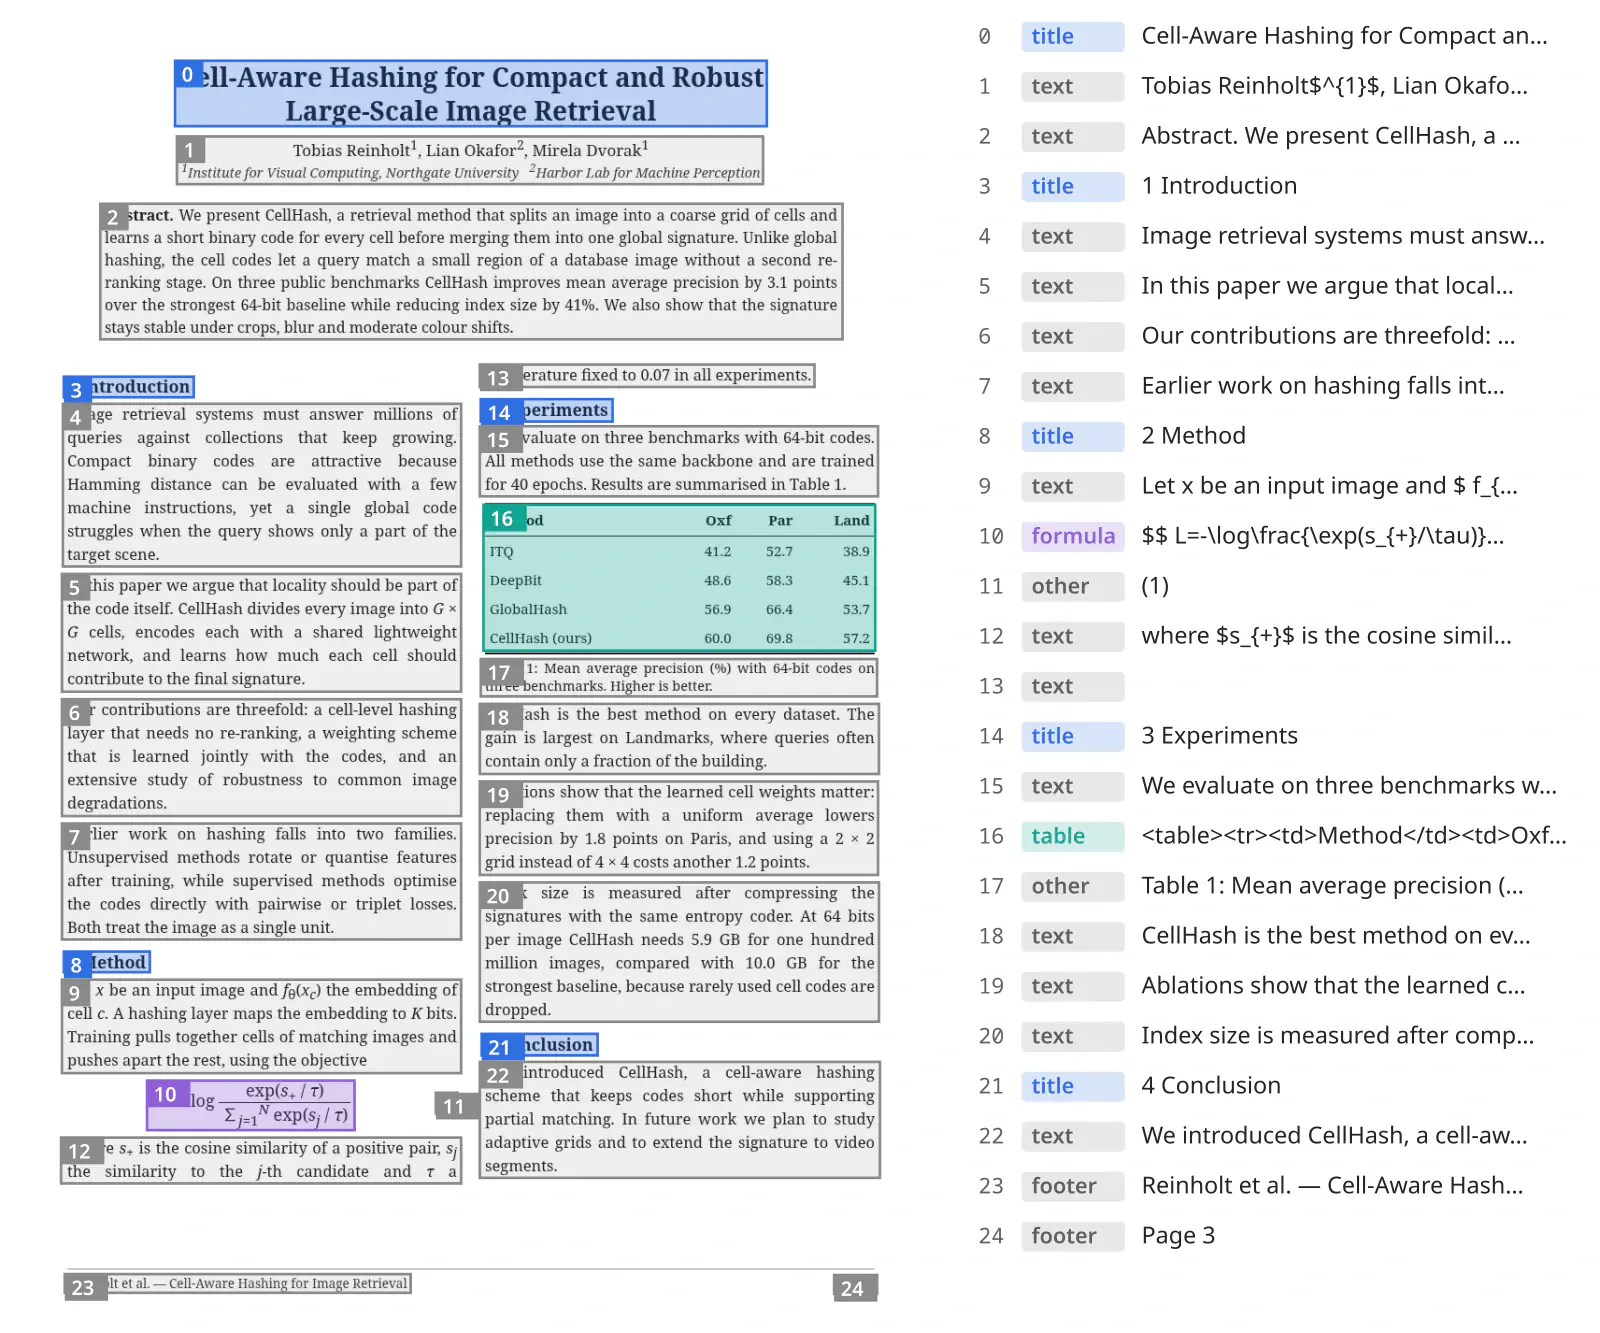
Playground 对一页双栏论文的实录结果。编号为 order;右侧列表显示 type 和 text 的开头,25 个区块中包括标题、文本、公式、表格和页脚。
options.blocks 为 false 时不返回 blocks,只返回 markdown。
HTML 表格
Section titled “HTML 表格”table 类型的区块把表格作为 HTML <table> 放在 text 和 markdown 中,行、列和表头单元格得以保留,可直接渲染或解析。
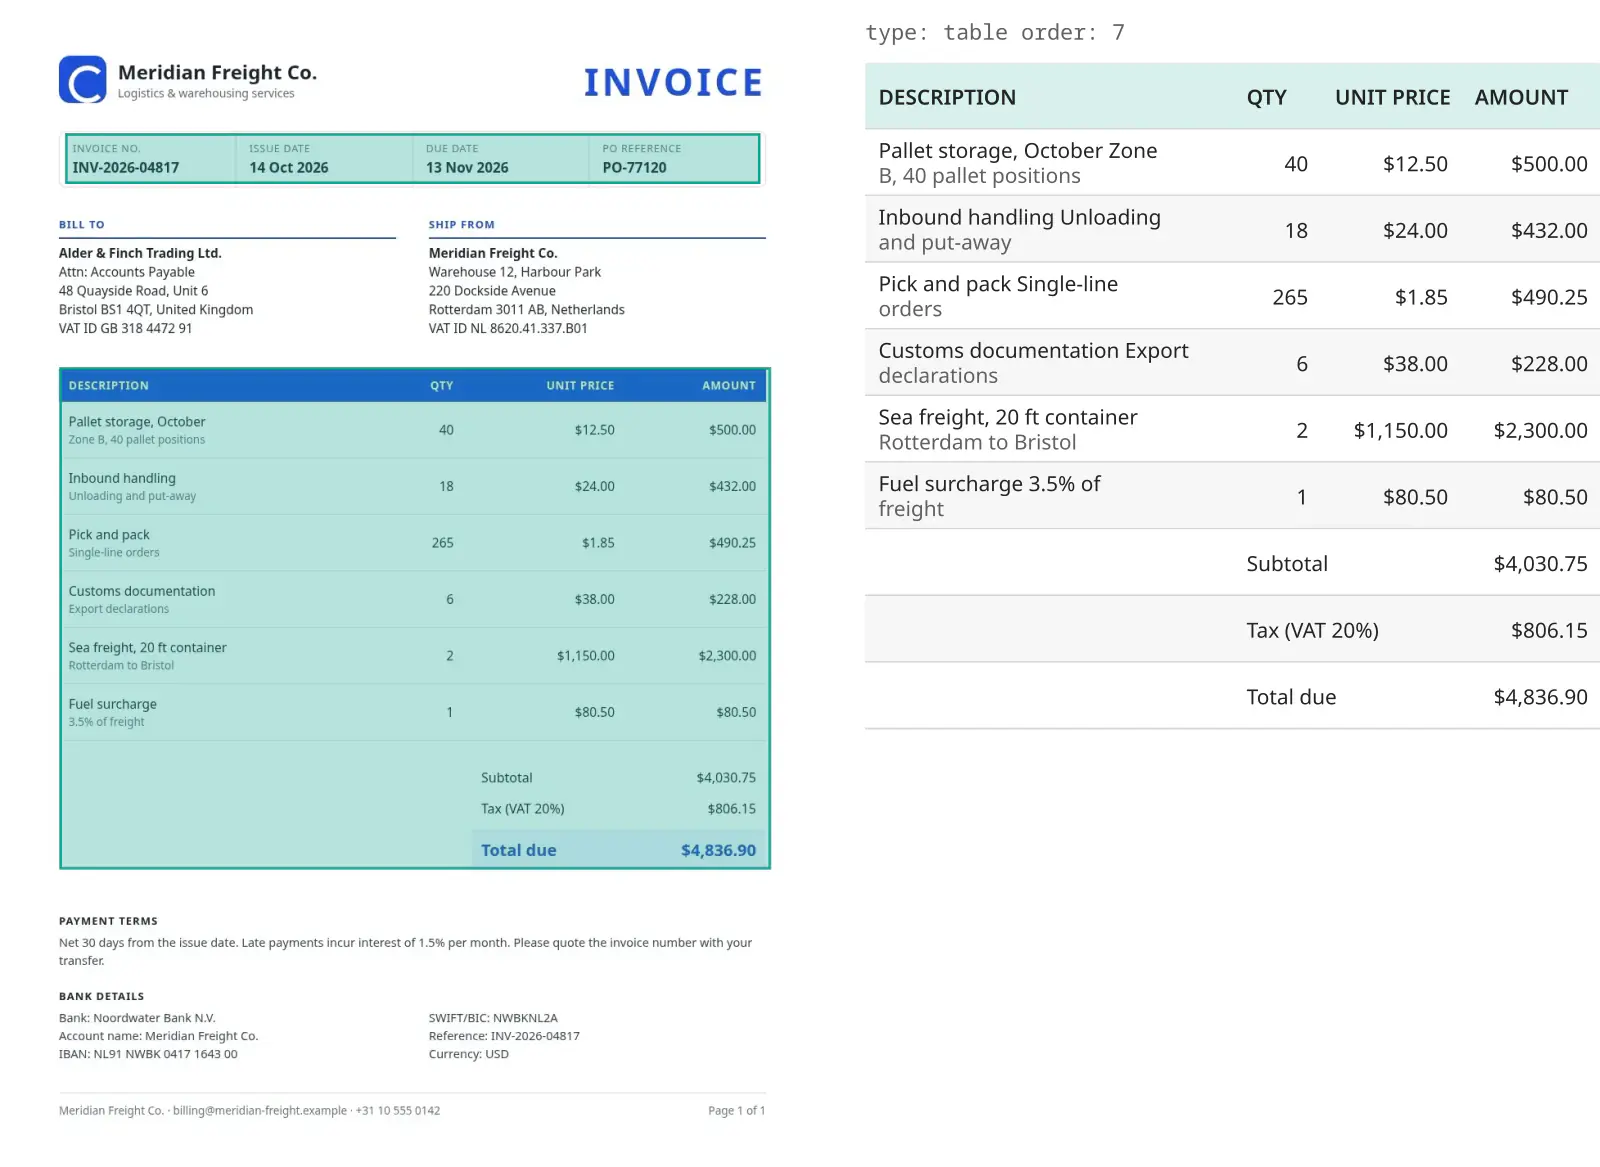
Playground 对一张发票的实录结果。青色框是 table 类型的区块;右侧是 order 为 7 的区块的 HTML 渲染结果。
LaTeX 公式
Section titled “LaTeX 公式”formula 类型的区块把独立成行的公式作为 LaTeX 返回,以 $$ 包围。夹在正文行内的公式留在该区块的 text 和 markdown 中,以 $ 包围。
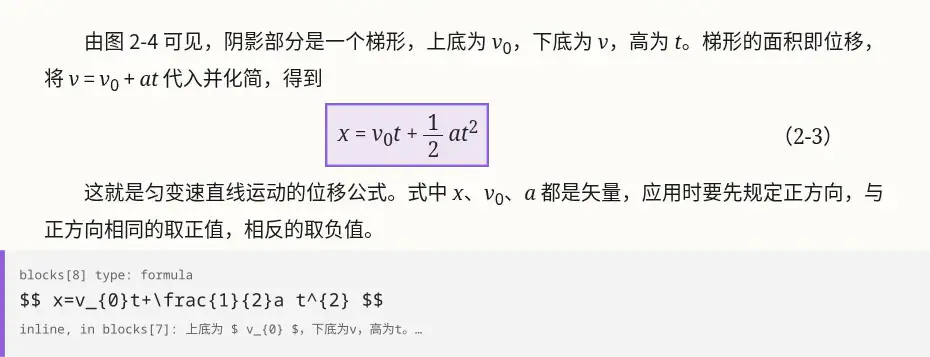
Playground 对一页教材的实录结果。框出的独立公式是 formula 类型的区块;识别出的 LaTeX 显示在页面下方,并附有相邻 text 区块中的一个行内公式。
paddleocr-vl 是 POST /v1/documents/parse 的默认模型,也是唯一的模型。
paddleocr-vl是面向文档的模型:带框的有类型区块、阅读顺序、HTML 表格、LaTeX 公式,以及整页的 Markdown。按页计费,仅在付费池中可用。ppocr-v6返回纯文字行和字级框,不返回版面、阅读顺序、表格和公式,是截图、裁剪区域和复制文字类 OCR 的低成本选择。两者的对比表见文字识别(OCR)。
将一页发票图片发送到 POST /v1/documents/parse,同时返回版面区块:
curl https://api.stack.foldbun.com/v1/documents/parse \ -H "Authorization: Bearer $FOLDBUN_API_KEY" \ -H "Content-Type: application/json" \ -d '{ "model": "paddleocr-vl", "image": { "id": "img_e0100380a624332f4161c651ea355c84914159eaa064df2db226519dadb944e7" }, "options": { "blocks": true } }'以下响应有删减:该页有更多区块,Markdown 字符串也更长。
{ "id": "call_01a1913d-e9ef-767e-8ca1-f490b0af5533", "model": "paddleocr-vl", "image": { "id": "img_e0100380a624332f4161c651ea355c84914159eaa064df2db226519dadb944e7", "width": 1008, "height": 1426, "bytes": 143151, "contentType": "image/jpeg" }, "pages": 1, "markdown": "INVOICE\n\n<table>...</table>\n\n## BILL TO\n\nAlder & Finch Trading Ltd.\n...", "blocks": [ { "type": "header", "order": 1, "bbox": [710, 76, 933, 124], "text": "INVOICE", "markdown": "INVOICE" }, { "type": "table", "order": 2, "bbox": [81, 164, 928, 223], "text": "<table><tr><td>INVOICE NO.</td><td>ISSUE DATE</td></tr><tr><td>INV-2026-04817</td><td>14 Oct 2026</td></tr></table>", "markdown": "<table><tr><td>INVOICE NO.</td><td>ISSUE DATE</td></tr><tr><td>INV-2026-04817</td><td>14 Oct 2026</td></tr></table>" } ], "cost": 2, "balance": 996, "timing": { "queueMs": 0, "processingMs": 1294 }, "billing": { "lines": [ { "unit": "page", "quantity": 1, "unitPrice": 2, "amount": 2, "waived": false } ], "total": 2, "charged": true, "pool": null }}pages为 1:一次请求是一页图片。markdown为按阅读顺序排列的整页内容,表格为 HTML。blocks为每个版面区域一项,JSON 中显示其中两项。此处type为header和table,order为阅读顺序,bbox为[x1, y1, x2, y2],单位为摆正后的原图的像素,此处为 1008 × 1426(image.width、image.height)。text为区块识别出的文字。table区块的text和markdown均为 HTML<table>。billing.charged为true,pool为null:本次调用从余额中扣费,因此cost为 2。
全部字段:API 参考。
本次调用的费用。 每次调用 2(page)额度,与区块数量无关,与本响应的实际扣费一致。单价见计费。
| 接口 | 在本用例中 | 参考 |
|---|---|---|
POST /v1/documents/parse |
一页图片得到有序区块、HTML 表格、LaTeX 公式和整页 Markdown | API 参考 |
POST /v1/ocr |
返回纯文字行和字级框,而不是结构 | API 参考 |
paddleocr-vl:模型的工作原理、限制和实测延迟。- 计费:
paddleocr-vl每次调用计一个page。 - 文字识别(OCR):
ppocr-v6的纯文字行和字级框,以及两个模型的对比。