

嵌入与检索
嵌入把一张图片或一段文本转换为经 L2 归一化的向量。方向相近的向量描述相近的内容,因此可用于图像相似度、近重复检测、以图搜图、以文搜图,以及对照一组标签的零样本分类。该接口只返回向量:保存向量并按相似度排序由调用方自行处理。不同模型的向量不可比较,用某个模型建立索引的图片库,须用同一模型查询。
响应包含 dimensions(每个向量的长度)和 embeddings(每个输入对应一项)。向量是普通的 JSON 数字数组(float32 数值,不是 base64)。向量已做 L2 归一化,无需再次归一化:两个输入的余弦相似度等于其向量的点积,数值越高表示越相似。录制的响应中 dimensions 为 768;代码应读取该字段,而不是写死长度。
siglip2:图像与文本之间的得分数值很小。下方录制的示例中,最佳匹配得分为 0.133,无关组合约为 0。有意义的只是排名和得分之间的差距,因此应在同一个查询内部比较各得分,不假设固定的截断值。
先对查询图片和各候选图片分别生成嵌入,再按与查询向量的点积对候选图片排序。图片库较大时,应在客户端保存向量并使用向量索引;该接口只返回嵌入。
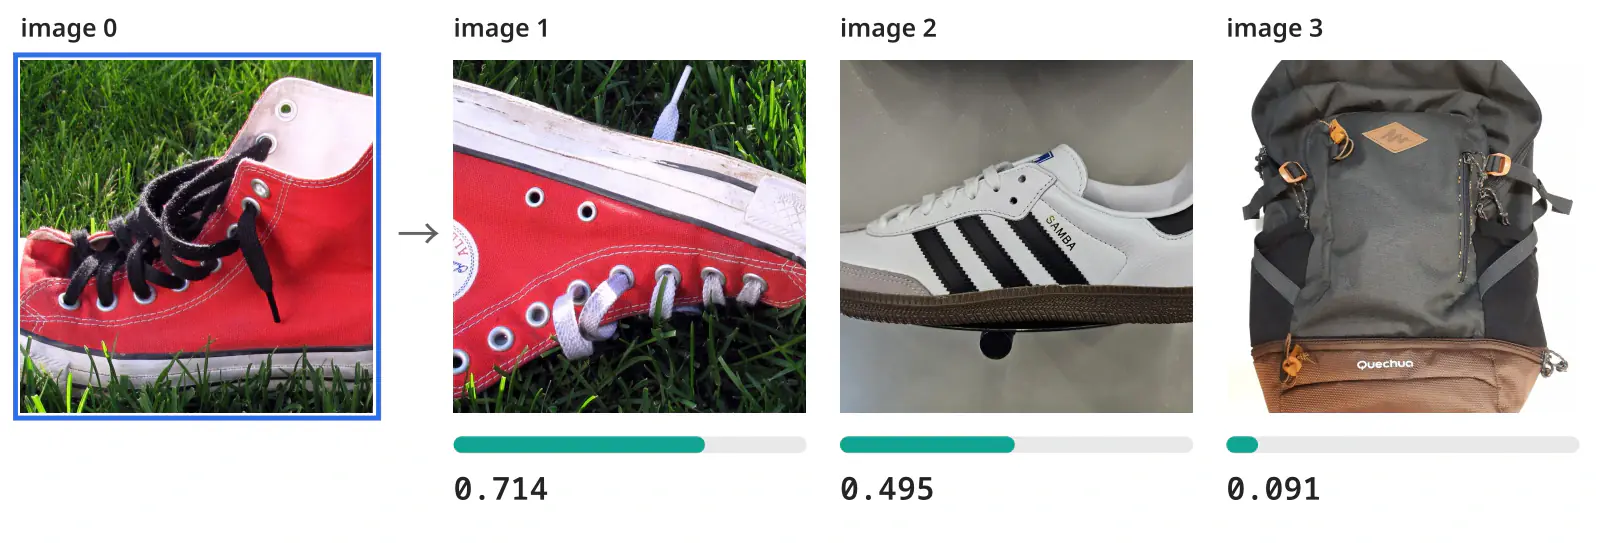
dinov3:Playground 的录制结果:查询图(image 0,蓝色边框)与另外三张图片的余弦相似度。外观最接近的图片得分最高,另一款运动鞋居中,无关物体接近零。
同一张图片的副本(重新编码、缩放或轻度编辑)与原图的得分,预期远高于无关图片,因此设定相似度阈值即可把同一个调用变成去重过滤器。API 不提供推荐阈值,应在图片库的带标注样本上确定。以图搜图时,先对查询图生成一次嵌入,与已保存的向量比较,返回得分最高的结果。
每张图片只需嵌入一次(每张图片一次调用)并保存向量。搜索时,用一次 texts 调用嵌入查询文本,再按点积对图片排序。仅含文本的调用,其响应中没有 image。
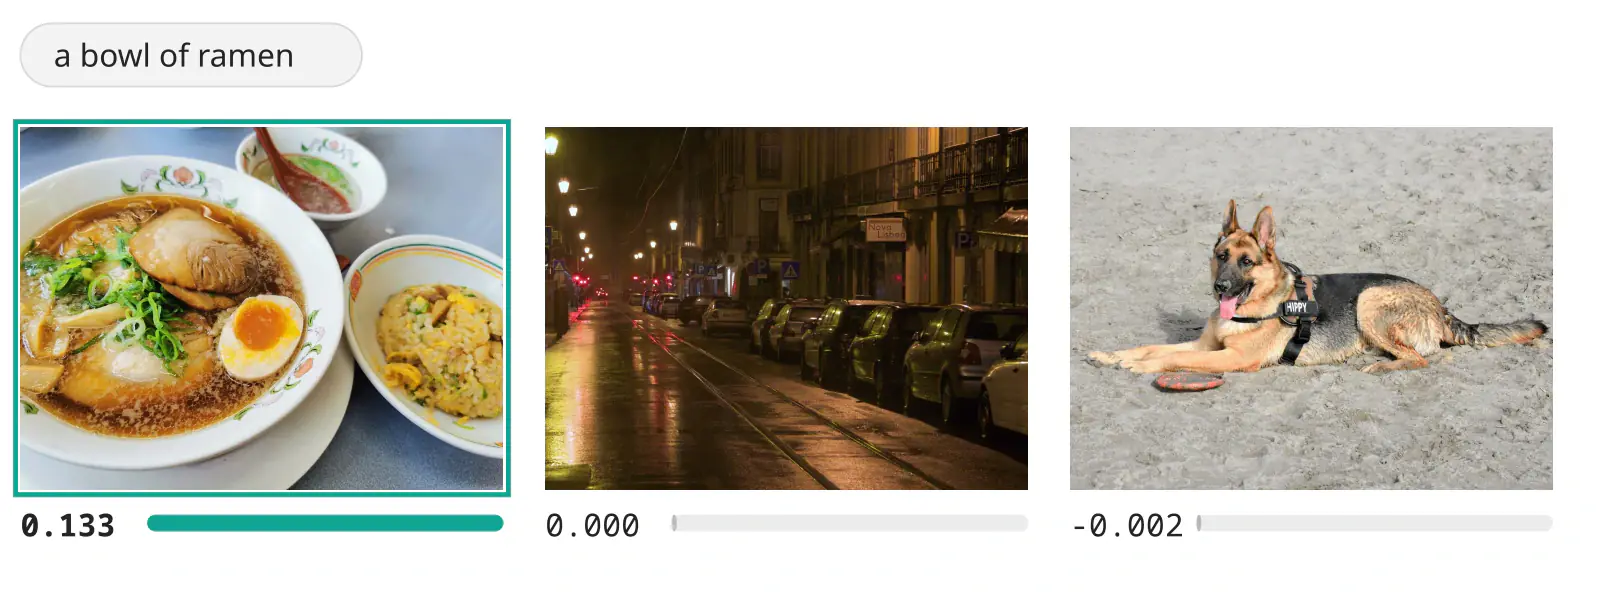
siglip2:Playground 的录制结果:一条文本查询对三张图片打分。拉面照片排名第一,另外两张得分约为 0。
嵌入一张图片和一组候选标签(每次调用最多 64 条),再按标签与图片的点积对标签排序,得分最高的标签即预测结果。标签就是普通文本,可以在每次请求中更换,无需重新训练。
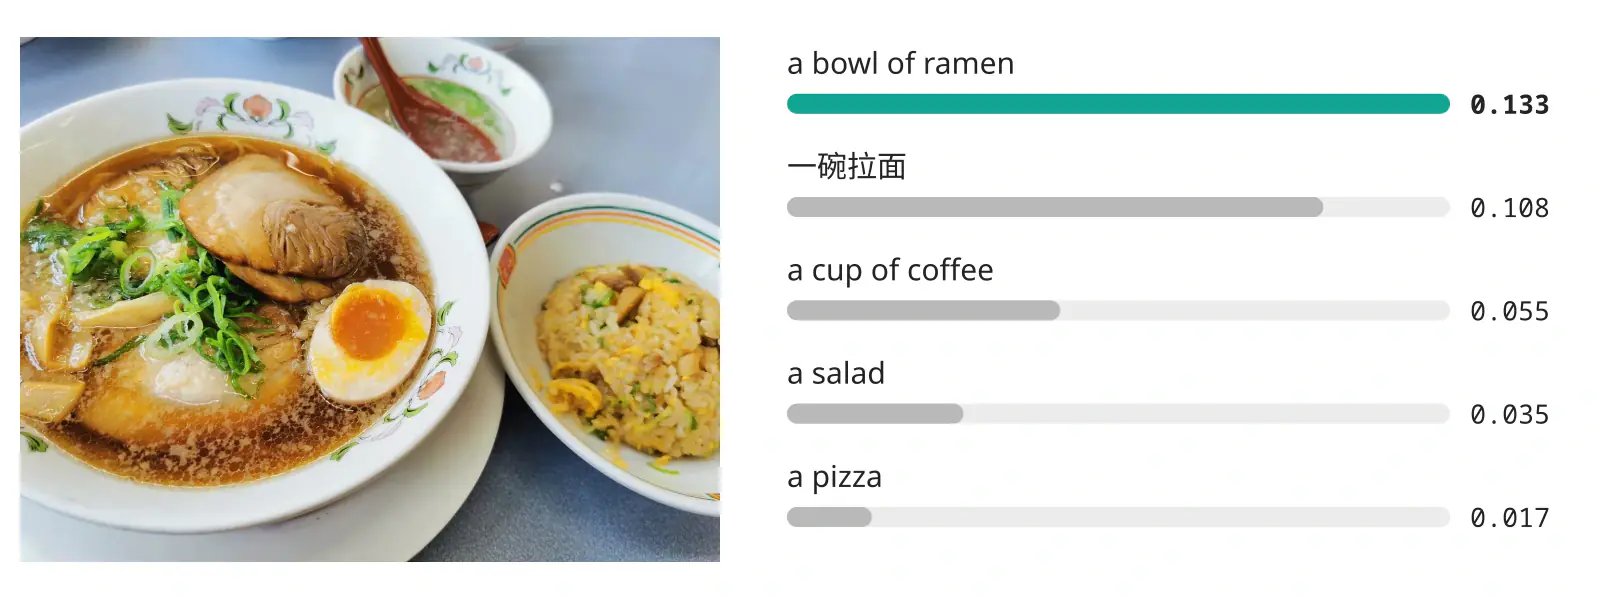
siglip2:Playground 的录制结果:一张图片对五个标签打分。匹配的标签排名第一,用中文描述同一道菜的标签排名第二。
dinov3 |
siglip2 |
|
|---|---|---|
| 模型 | DINOv3 ViT-B/16 | SigLIP 2 base,patch 16,224 px |
| 输入 | 一张图片 | 一张图片,或 1 到 64 条文本(每条 1 到 1000 个字符),二者不可同时给出 |
| 输出 | 每张图片一个纯视觉向量 | 每张图片或每条文本一个向量,位于同一个空间 |
| 标价(额度) | 每张图片 0.05 | 每张图片 0.05,每条文本 0.01 |
| 模型池 | 公共池:所有已注册账户可用,每个 UTC 日包含 100 次调用 | 公共池:所有已注册账户可用,每个 UTC 日包含 100 次调用 |
| 向量长度 | 录制的响应中为 768;请读取 dimensions |
录制的响应中为 768;请读取 dimensions |
| 录制的处理时间 | 216 ms(一次录制的调用) | 约 200 ms |
| 署名 | “Built with DINOv3” | 无 |
| 适用场景 | 查询内容是图片 | 查询内容是句子或一组标签,或需要将文本与图片互相比较 |
- 图像与图像之间的相似度、去重和以图搜图(“查找与这张相似的图片”),选用
dinov3。 - 以文搜图、零样本分类,以及需要将文本与图片互相比较的场景,选用
siglip2。
将第一张图中的图片用 dinov3 做嵌入:
curl https://api.stack.foldbun.com/v1/embeddings \ -H "Authorization: Bearer $FOLDBUN_API_KEY" \ -H "Content-Type: application/json" \ -d '{ "model": "dinov3", "image": { "id": "img_36aec8cbc5b68661a926869a8bc8aa79de584edbb2aec2454bd1f1c169af09d7" } }'以下响应有删减:向量已缩短。
{ "id": "call_01a1913e-868a-7d5a-841c-5913396a9ea1", "model": "dinov3", "image": { "id": "img_36aec8cbc5b68661a926869a8bc8aa79de584edbb2aec2454bd1f1c169af09d7", "width": 1512, "height": 1008, "bytes": 342140, "contentType": "image/jpeg" }, "dimensions": 768, "embeddings": [ { "index": 0, "vector": [-0.007488, -0.036278, -0.000432] } ], "cost": 0.05, "balance": 12.45, "timing": { "queueMs": 0, "processingMs": 216 }, "billing": { "lines": [ { "unit": "image", "quantity": 1, "unitPrice": 0.05, "amount": 0.05, "waived": false } ], "total": 0.05, "charged": true, "pool": null }}dimensions为 768:每个向量都是这个长度。代码应读取该字段,而不是写死长度。embeddings[0]包含index(0)和vector,即 L2 归一化的 float32 数值(768 个中显示 3 个)。index是在texts中的位置;图片为 0。- 仅含文本的
siglip2调用按输入顺序,为每条文本返回一项,且没有image。
同一模型的两个向量的余弦相似度等于它们的点积:
def cosine(a: list[float], b: list[float]) -> float: return sum(x * y for x, y in zip(a, b))两个向量来自使用同一模型的两次调用,每张图片一次。
全部字段:API 参考。
本次调用的费用。 0.05(image)额度,与本响应的实际扣费一致。使用 siglip2 时,图片同样为 0.05,每条文本为 0.01,因此下面流程中的三个标签共 0.03。单价见计费。
Python 完整流程
Section titled “Python 完整流程”完整的 Python 流程,图片和标签分两次调用:
import os
import requests
API = "https://api.stack.foldbun.com/v1/embeddings"HEADERS = {"Authorization": f"Bearer {os.environ['FOLDBUN_API_KEY']}"}

def embed(**body):    r = requests.post(API, headers=HEADERS, json={"model": "siglip2", **body}, timeout=60)    r.raise_for_status()    return [e["vector"] for e in r.json()["embeddings"]]

texts = ["a bowl of ramen", "a pizza", "a salad"]image_vec = embed(image={"id": "img_f4e4f5a8a14f25689a345acf67ea1a83c5760e219c0dcf5255717cdb9bd5e225"})[0]scores = [sum(a * b for a, b in zip(image_vec, v)) for v in embed(texts=texts)]for text, score in sorted(zip(texts, scores), key=lambda p: -p[1]): print(f"{score:.3f} {text}")| 接口 | 在本用例中 | 参考 |
|---|---|---|
POST /v1/embeddings |
每张图片一个向量;使用 siglip2 时每条文本也一个向量,按输入顺序返回 |
API 参考 |